
图像生成
Z-Image-Turbo
面向本地文本到图像生成的蒸馏扩散模型。验证覆盖多分辨率生成延迟、连续请求稳定性,以及写实画面和中英文文字表现。
跨模态生成文本 → 图像
01 / 模型参数
模型架构与能力
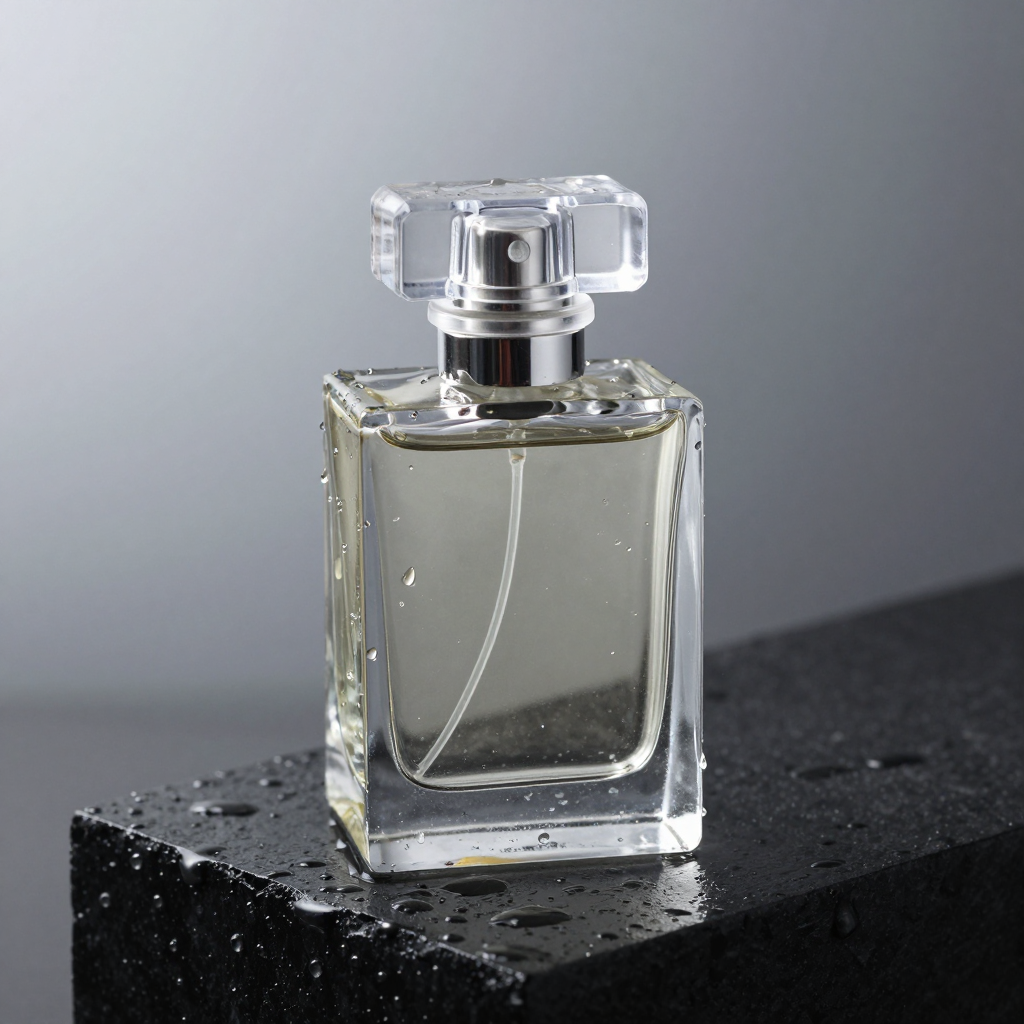
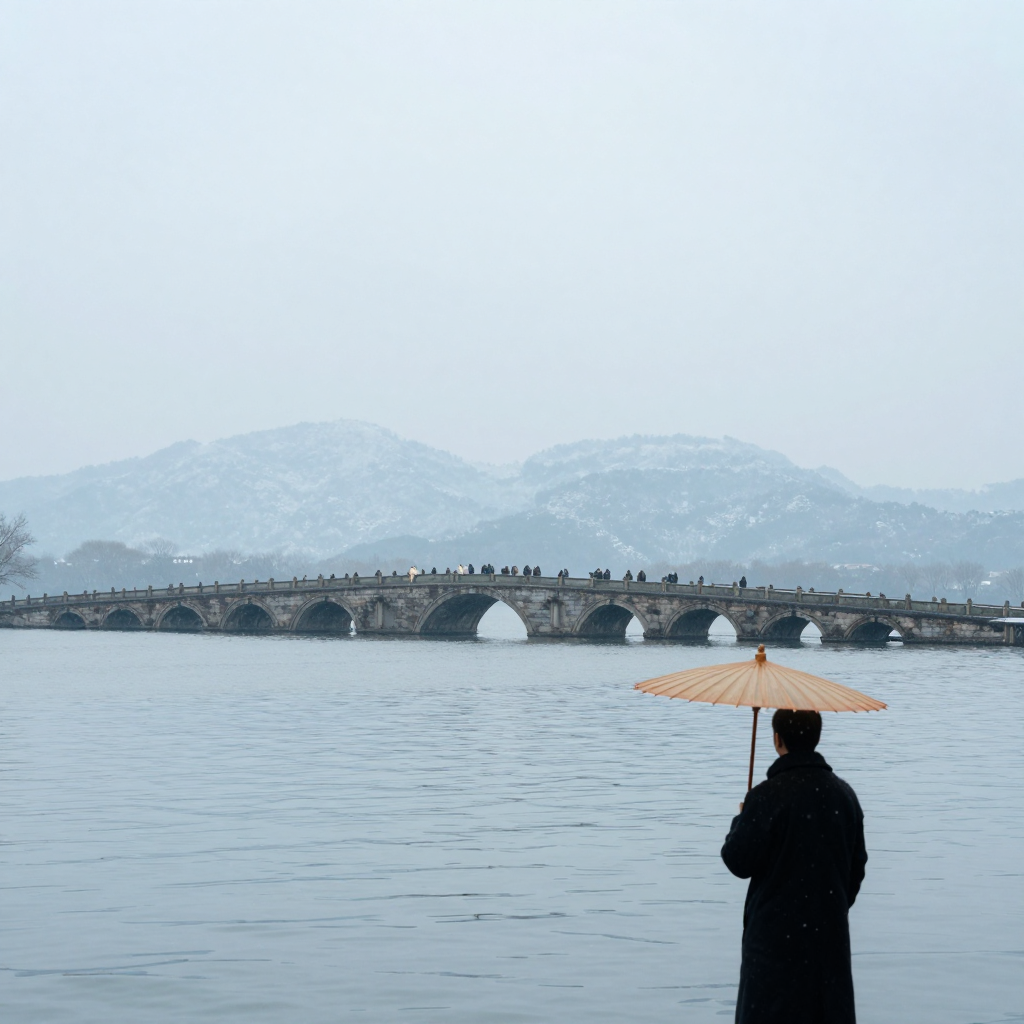
Z-Image-Turbo 是通义发布的蒸馏文生图模型,采用单流扩散 Transformer,将文字描述转为图像。它面向少步数生成、写实画面和中英文文字表现;本页提供 MegaCube 上不同分辨率的耗时以及固定提示词样张,便于同时观察速度与画面质量。
- 写实画面和产品创意图
- 中英文短文字海报
- 插画与内容配图
- 发布方 / 模型
- 通义 · Tongyi-MAI/Z-Image-Turbo
- 参数规模 / 架构
- 6B 扩散主干;Single-Stream DiT;文本编码等组件另计
- 输入 / 输出
- 文字描述输入;静态图像输出
- 生成步数
- 蒸馏模型约 8 次网络评估;本次 Diffusers 配置 num_inference_steps=9
- 本页精度 / 文件
- BF16;含各组件约 32.90 GB,7 个大权重分片
- 固定权重版本
- f332072aa78be7aecdf3ee76d5c247082da564a6
- 许可证
- Apache-2.0
Turbo 版本用于文生图。精确计数与较长文字可能有误差,可结合下方样张与测试条件评估。
模型资料核对于 2026-09-20
02 / 部署方式
MegaCube 部署配置
- 计算设备
- 1 × MegaCube · NVIDIA GB10 · 128 GB
- 推理框架
- Diffusers 0.40.0 · ARM64 容器
- 采样
- BF16 · 9 Steps
- 执行方式
- GPU 串行出图;并发请求进入队列
- 图像输出
- 本次测试 512×512 至 1280×1280
下载固定权重
使用 Tongyi-MAI/Z-Image-Turbo 的指定 revision,保留完整模型文件。
校验文件
核对 7 个大权重分片的精确字节数与模型版本。
启动容器服务
使用 ARM64 推理环境与 Diffusers 0.40.0,配置 BF16 和 9 步采样。
验证生成
完成健康检查和真实出图,再按需要测试分辨率及排队策略。
在本地模型商店中找到此模型,下载后按卡片指引部署并启用。
下载本地模型商店 →03 / 性能测试
MegaCube 性能测试结果
2026-09-11;单台 GB10;BF16、9 步。完整矩阵共 100 次请求。纯生成耗时来自服务端,端到端耗时包含请求、PNG 编码和接收。
2.745 s512×512 · 10 次平均纯生成
12.179 s1024×1024 · 10 次平均纯生成
100 / 100完整请求矩阵成功
| 分辨率 | 次数 | 成功 | 纯生成平均 | P95 | 端到端平均 |
|---|---|---|---|---|---|
| 512×512 | 10 | 100% | 2.745s | 2.753s | 2.809s |
| 768×768 | 10 | 100% | 6.933s | 6.948s | 7.086s |
| 768×1024 | 5 | 100% | 9.092s | 9.098s | 9.303s |
| 1024×768 | 5 | 100% | 9.097s | 9.109s | 9.300s |
| 1024×1024 | 10 | 100% | 12.179s | 12.189s | 12.458s |
| 1280×1280 | 3 | 100% | 19.491s | 19.621s | 19.935s |
- 当前服务串行生成,并发请求不会提高总吞吐。
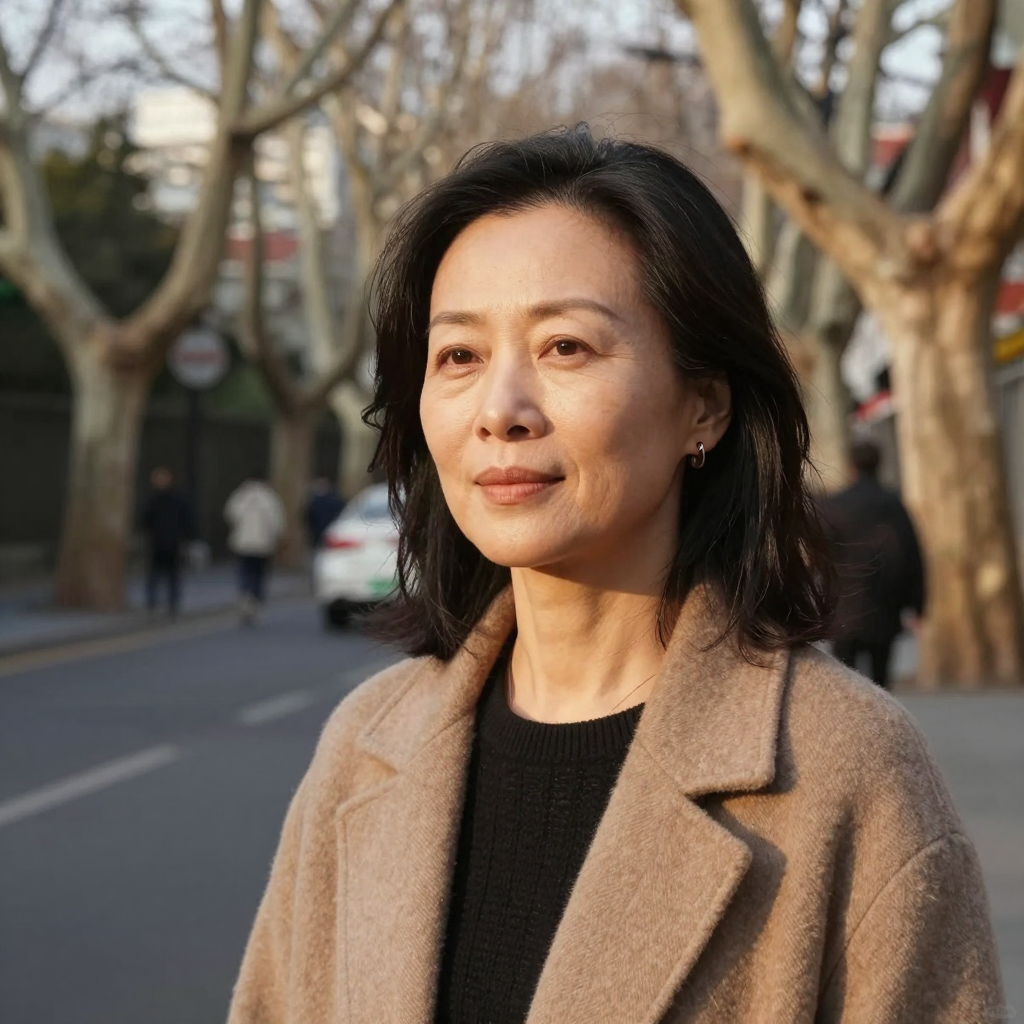
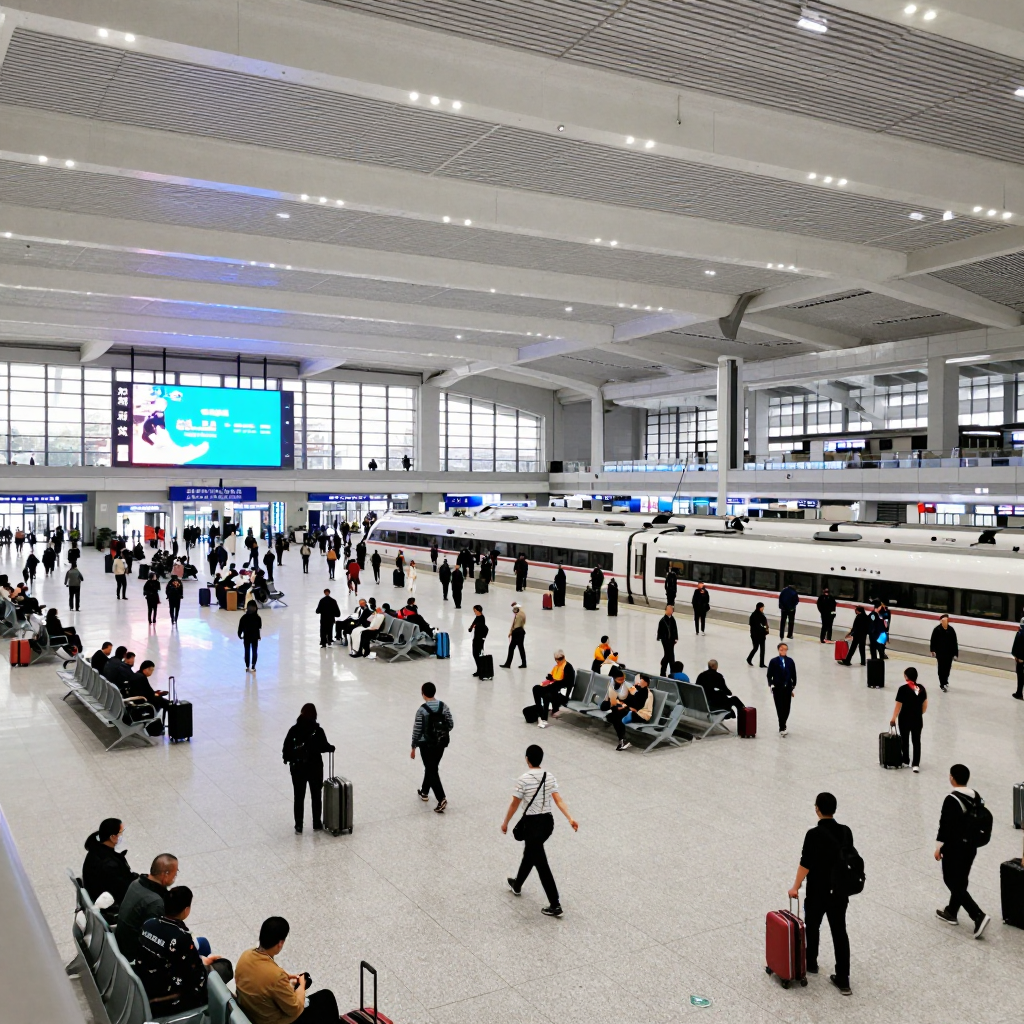
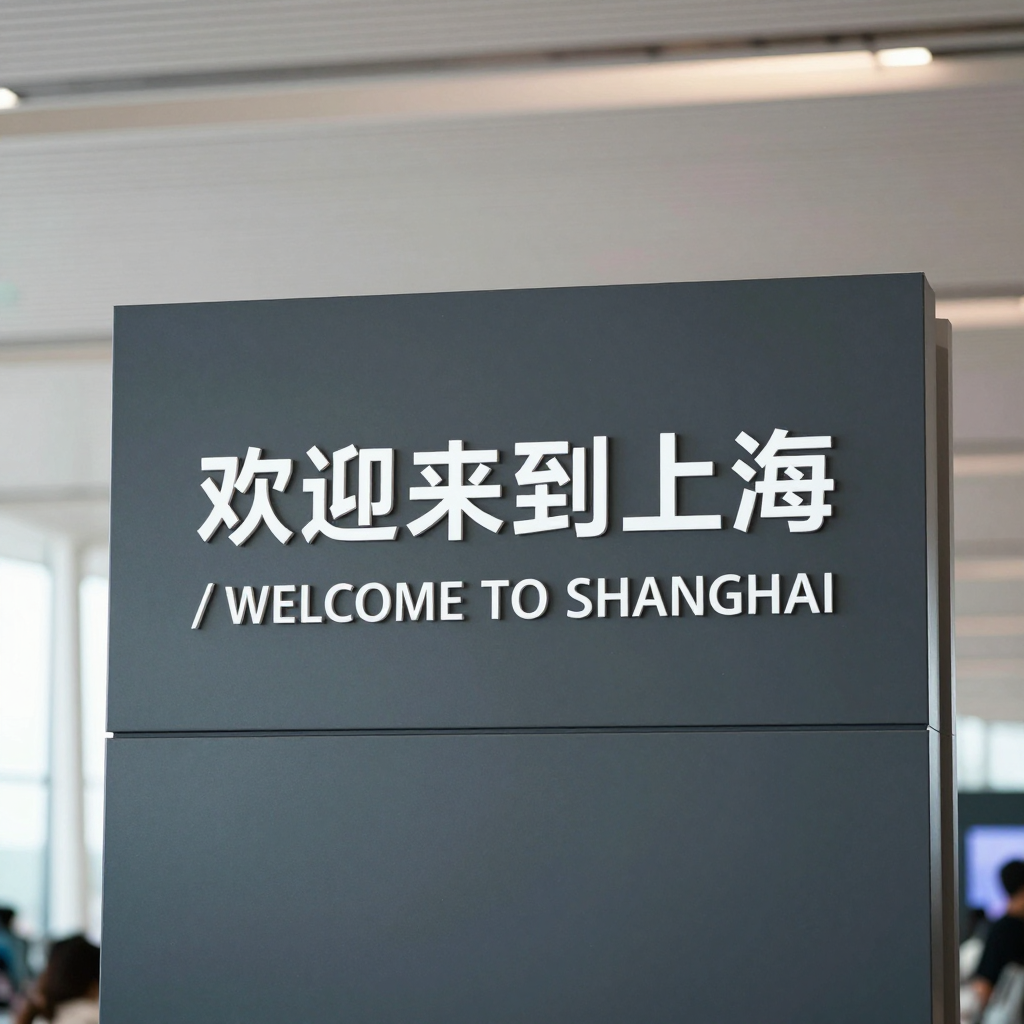
- 20 项固定 seed 人工检查中,16 项完整满足、2 项部分满足、2 项未满足;精确计数与较长英文仍有误差。
规划模型部署与应用集成
根据模型规模、业务任务与并发需求,评估设备配置和推理服务。