需求选型

方案与配置

从目标模型、上下文长度和同时使用人数出发,判断单机是否满足,再选择多副本服务或多机模型并行。

配置以具体模型和任务验证为依据。查看已验证配置 →

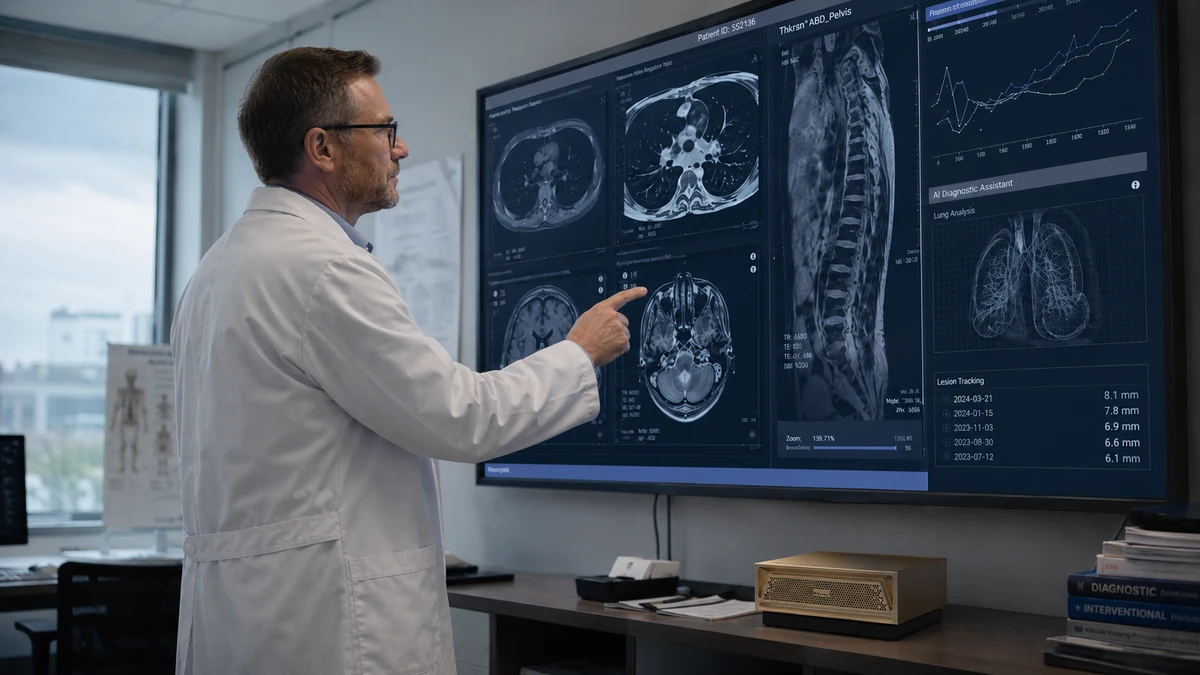
MegaCube 用于原型设计的桌面工作场景 MegaCube 用于模型微调的开发工作场景 MegaCube 用于科学计算的实验室场景 MegaCube 用于多模态推理的医学影像场景 MegaCube 用于边缘部署的数据中心场景
01 / 05

01 / 场景方案

按模型容量与并发需求选型

查看单机模型配置 →
先做一个判断

先判断模型容量与并发目标

模型容量决定是否需要多机合跑,并发目标决定是否需要增加模型副本。两种问题对应两种扩展方式。

单机容量参考≤ 200B低精度量化下的能力上限,具体以模型、上下文长度与实测为准
产品能力说明 ↗
容量与并发都满足1 台 Cube1 份完整模型看单机配置 ↓
01
模型装得下,但并发不够

多副本推理

用户请求负载均衡
Cube 1模型副本Cube 2模型副本+ N

每台 Cube 运行一份相同模型,通过负载均衡分发请求,主要用于提升并发能力与整体吞吐。

咨询并发方案 →
02
模型装不下单台资源

多机模型并行

一个模型实例
Cube 1Cube 2Cube 3Cube N
高速互联

通过模型并行把一个模型分布到多台 Cube,利用高速网络完成跨节点通信,先解决模型容量问题。

看多机配置 ↓
两个实际例子

从已验证的单机与集群基线继续扩展

先解决“能不能跑”,再根据并发、吞吐和延迟目标决定扩容方式。

案例 01 · 模型已装下

Qwen3.6-35B:单机 8 并发,想要更高并发怎么办

当前基线
1台 MegaCube
8并发

单机运行一份完整模型

增加独立模型副本
请求负载均衡
Cube 1Qwen3.6-35BCube 2Qwen3.6-35B+ N继续扩展

可按 8 并发 / 台作为估算起点,最终以相同模型、上下文和请求规模压测确认。

推荐配置N 台 Cube = N 份独立副本

增加 Cube 数量,部署相同模型副本,并配置负载均衡。例如目标约 16 并发,可先评估 2 台,再按压测结果调整。

评估并发方案 →
案例 02 · 模型超出单机容量

DeepSeek-V4.1-Flash:4 台部署后,如何继续提升并发与吞吐

当前基线
4台组成 1 组
1个模型实例

通过模型并行解决容量问题

按 4 台一组复制模型实例
请求负载均衡
模型副本 A
1234
4 台模型并行
再增加 4 台
模型副本 B
5678
新增模型副本

4 台先解决“跑得起来”;继续提升吞吐时,增加第二组、第三组 4 台模型副本,再由负载均衡分发请求。

推荐配置4 台一组扩展吞吐

不要把 4 台简单理解为 4 份服务。每 4 台共同承载一个模型实例;更多并发时复制整组,并配套高速网络与负载均衡。

咨询集群扩展 →

最终台数以模型适配、上下文长度、并发用户数、首 token 延迟与吞吐压测为准。多机模型并行还需要匹配 200GbE / RoCEv2 等高速互联条件。

02 / 配置清单

主机与建议配件

每台 GB10 · 128 GB 统一系统内存
存储可选 1 / 2 / 4 TB,按模型配置。

双节点模型并行

双机级联

Cube 1Cube 21 根 DAC 直连

建议配件

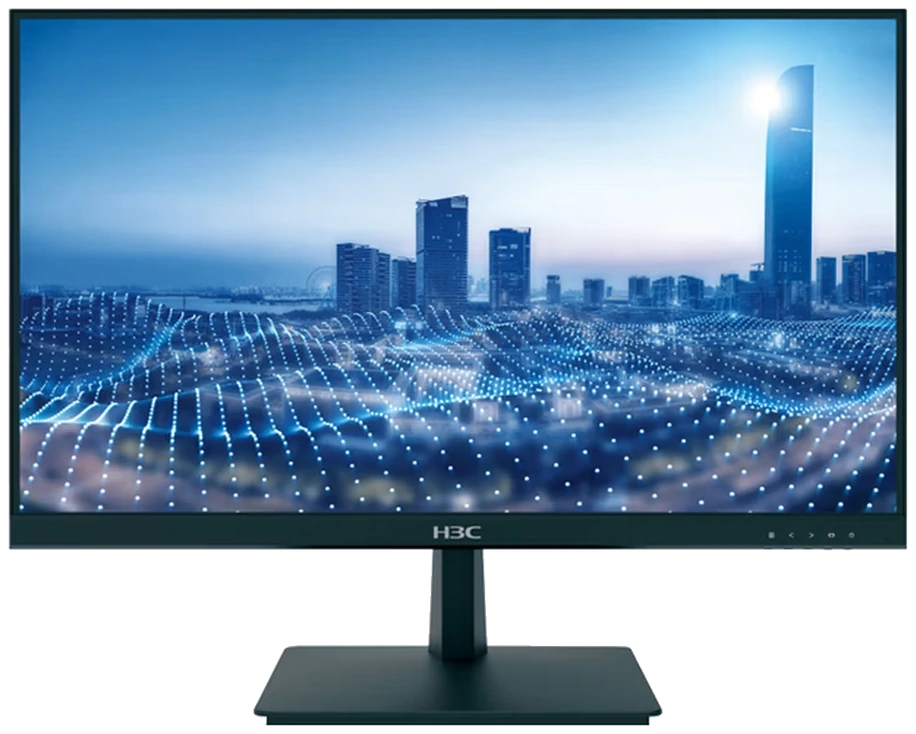
  • 显示器显示器1 台
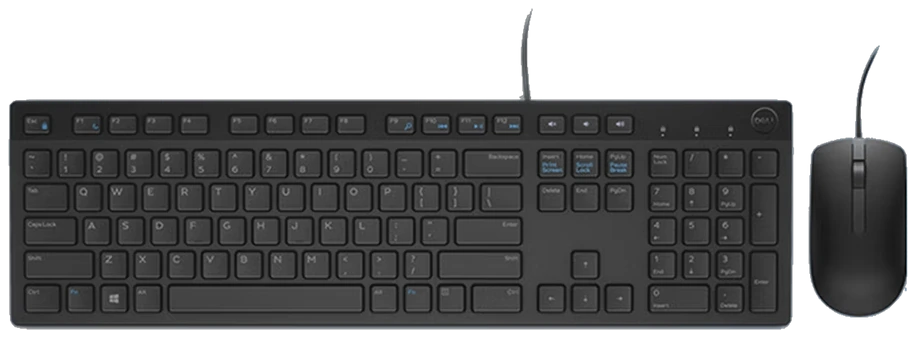
  • 键盘鼠标键盘鼠标1 套
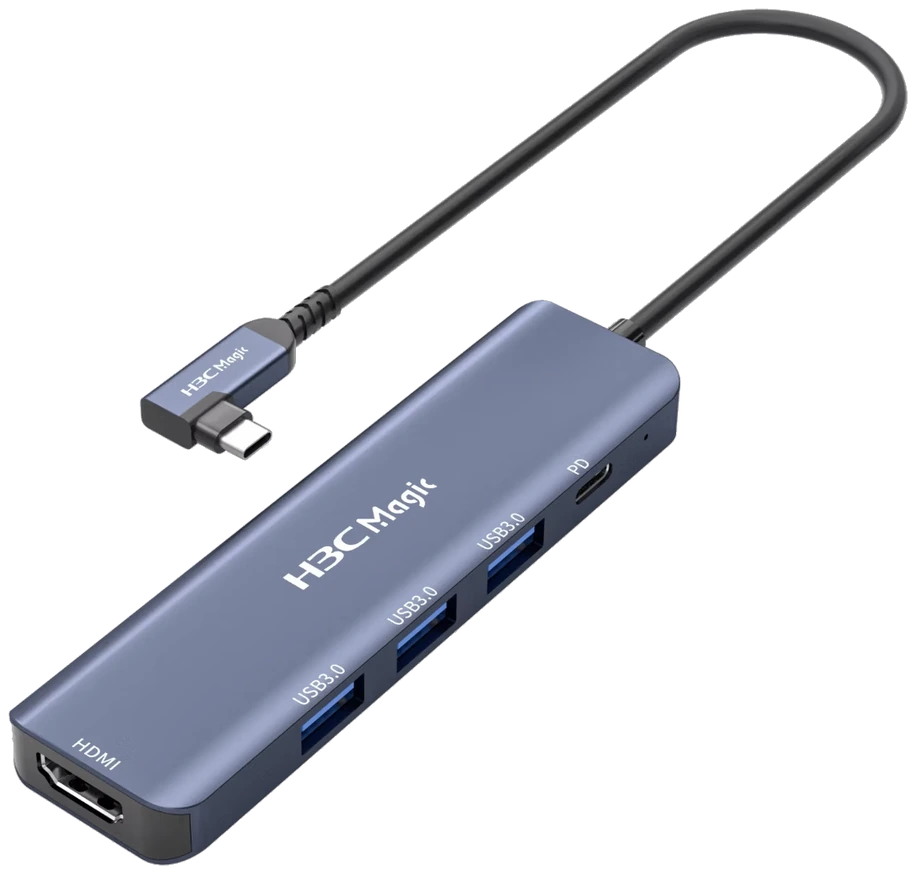
  • Type-C 扩展坞扩展坞1 个
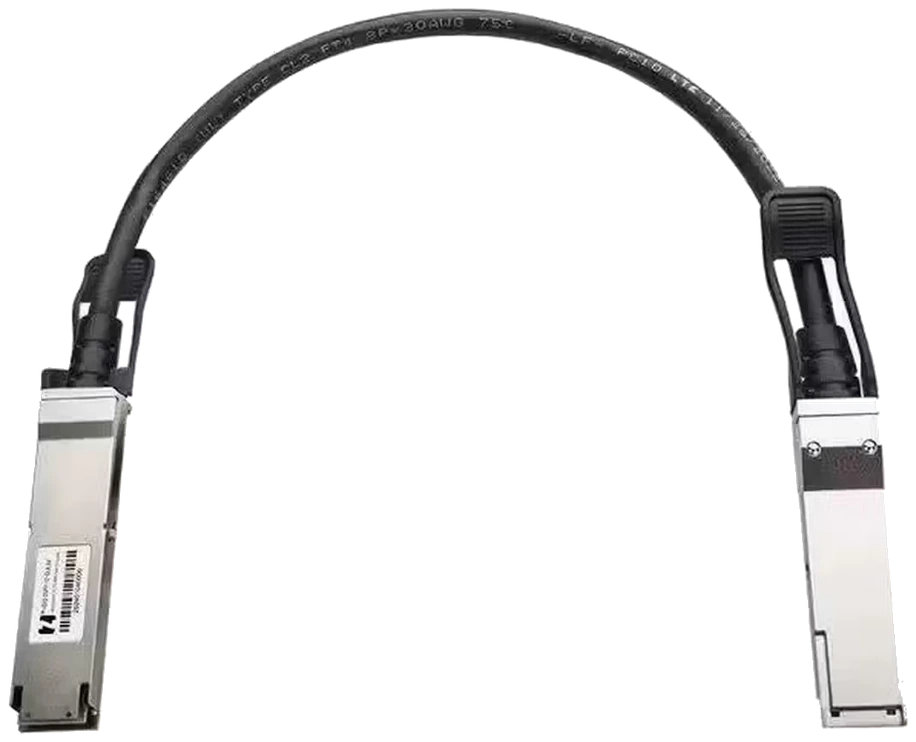
  • QSFP56-DAC 线缆DAC 线缆1 根

1 根 QSFP56-DAC 直连两台主机。

多节点分布式推理

多机级联

Cube 1Cube 2Cube 3Cube 4MegaCube × N

建议配件

  • 显示器显示器1 台
  • 键盘鼠标键盘鼠标1 套
  • Type-C 扩展坞扩展坞1 个
  • QSFP56-DAC 线缆DAC 线缆N 根
  • 交换机1 台

N 台配 N 根 QSFP56-DAC,
交换机至少提供 N 个兼容的 200G 端口。

配件可复用或另选;双机、多机外设按共用一套列出。DAC 与 200G 交换机用于大模型级联,具体配套以确认方案为准。

03 / 获取方案

明确部署需求

结合应用任务与性能目标,
评估模型、设备与网络配置。

01

任务与模型

目标应用、模型版本、输入类型与上下文长度。

02

并发与延迟

并发用户数、请求规模、首 token 延迟与吞吐目标。

03

数据与网络

数据存储位置、内外网边界与现有网络资源。

04

预算与时间

预算范围、交付周期与验收要求。

获取部署方案与配置报价

一起确认模型、主机数量、建议配件与所需服务。